AI 与产业
Harness 已死?
一场关于 Agent 外壳的冷静辩护
一个在 Cursor 和 Grok Bot 上做了最久 Agent 外壳的工程师,被问了一个尖刻的问题:模型越来越强,你这层还留着干什么?他的回答不是辩护,是把这层东西重新拆了一遍。
AI ENGINEER · NEW YORK
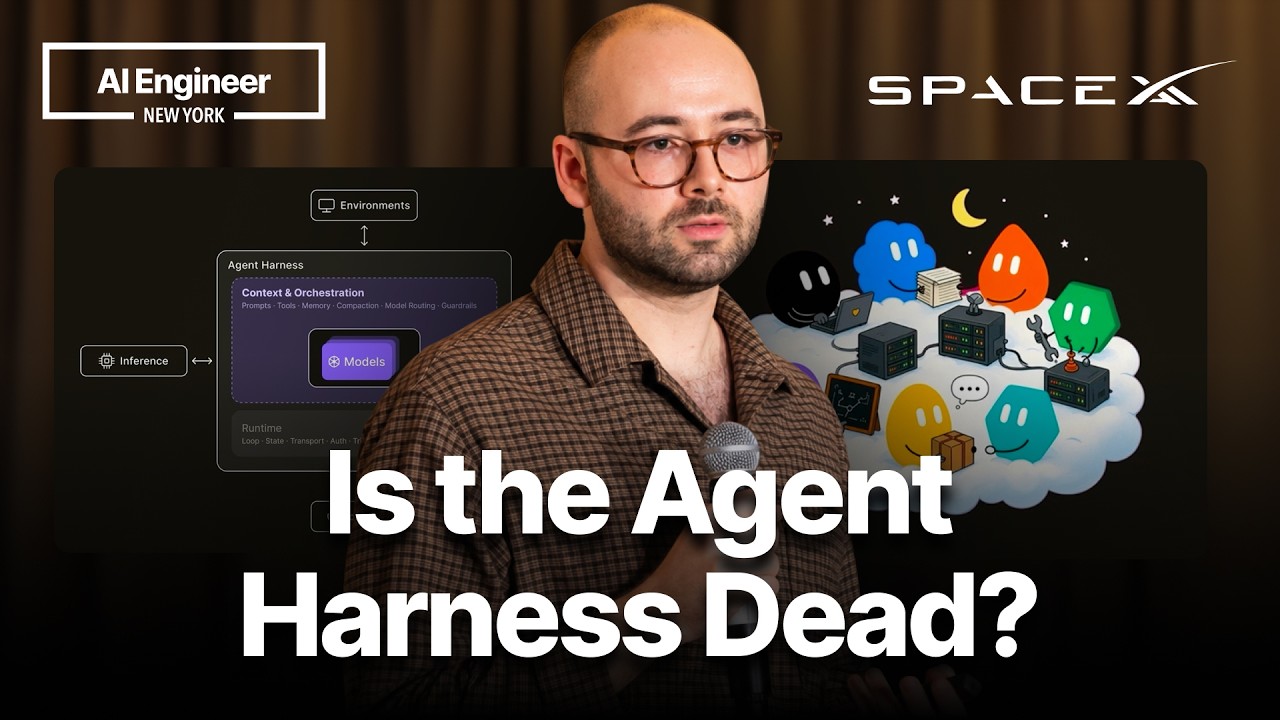
每过半年,就会有人宣布某个「中间层」要消失了:先是提示词工程,然后是 RAG,再然后是 Agent 框架。这一轮被点名的是 harness——那个包在模型外面、负责让它真的能把事做完的东西。这场演讲的价值在于:讲者既不是唱多的布道者,也不是唱空的旁观者,他是那个亲手删过自己代码的人。
适合谁读:做 Agent
产品的工程与产品同学、正在决定「哪一层自研、哪一层直接用」的团队、需要判断「模型升级后我的护城河还在不在」的人。不需要预先懂
harness,第 1 节会把名词讲清楚。
01 名词先行
Harness 不是一个框架,是「模型之外的全部」“If you're not the model, you're the harness.”
这句话来自 LangChain 的 Vivek Trivedy,是行业里流传最广的一句定义:只要你不是模型本身,你就是 harness。它听上去像废话,但恰好说明了为什么这层东西总被低估——因为它没有固定形状,模型每变强一次,它的边界就往后挪一次。
换个更好懂的比喻:模型是发动机,harness 是底盘、变速箱、方向盘、仪表盘和刹车。同一台发动机装进不同的车,能跑多快、能开多远、会不会翻车,完全不是一回事。而发动机功率翻倍的时候,底盘不是「没用了」,是得重做。
它里面到底装了什么
讲者给出的分层和那张封面图一致,可以压缩成两张皮:运行时层管「在哪跑、断了怎么接上」,上下文与编排层管「模型此刻能看到什么、 什么时候该换个人来干」。他自己管第二层叫「蛮荒西部」——规则最不清楚、迭代最快、也最吃经验的地方。
Agent Harness · 分层结构(据演讲封面架构图重绘)
Environments
IDE · Browser · Terminal · Cloud sandbox · Phone
Agent Harness
Context & Orchestration
PromptsToolsMemoryCompactionModel RoutingGuardrails
Runtime
LoopStateTransportAuthTracing
Models
the model itself
Inference
值得单独说一句的是 Compaction(压缩)和 Model Routing(模型路由)这两个词。前者决定长对话被怎样折叠成「还记得的部分」,后者决定哪一步该交给便宜模型、哪一步必须用贵的。这两件事模型自己都不做,但它们对最终体验的影响,往往比换模型大。
02 讲者
为什么这个人的话值得听Cursor → SpaceXAI → Grok Bot
Jediah Katz 于 2025 年初加入 Cursor,自述是在 agent harness 上工作时间最久的工程师之一。Cursor 被 SpaceX 收购(2026 年 6 月宣布,约 600 亿美元全股票交易)之后,他进入 SpaceXAI,参与 Grok Bot 的 harness 工作。
这个履历有意思的地方在于:他先后待过的两个 harness,一个是把编程任务做到极致的(Cursor),一个是把「替人办事」作为目标的(Grok Bot)。所以他能同时提供两种经验——一种关于「什么正在被模型吃掉」,一种关于「什么反而要加回来」。官方推文把这场演讲概括成一句话:inside Grok Bot, is the agent harness dead?
03 头衔变迁
三年,三个头衔,每一次都是被吃掉一层之后往上游挪一格prompt → context → harness
演讲开头给了一条很干净的线索:同一个岗位在三年里换了三次名字。这条线索本身就是「模型吃掉中间层」的实测记录。
| 时间 | 头衔 | 当时的核心工作 | 后来被谁接手 |
|---|---|---|---|
| 2023 | Prompt Engineer | 把话说明白,让模型输出可用 | 模型理解力提升 + 指令微调 |
| 2025 中 | Context Engineer | 决定模型此刻该看到哪些信息 | 长上下文与检索能力 |
| 2026 | Harness Engineer | 循环、状态、权限、成本、边界 | 正在被追问中 |
头衔不是营销词,是「哪一层还有真问题」的指示器。当某个头衔开始被大量嘲讽,通常意味着那层活已经被模型吸收得差不多了。
04 真正的减法
「harness 已经不再贡献编程智力」The harness no longer adds coding intelligence.
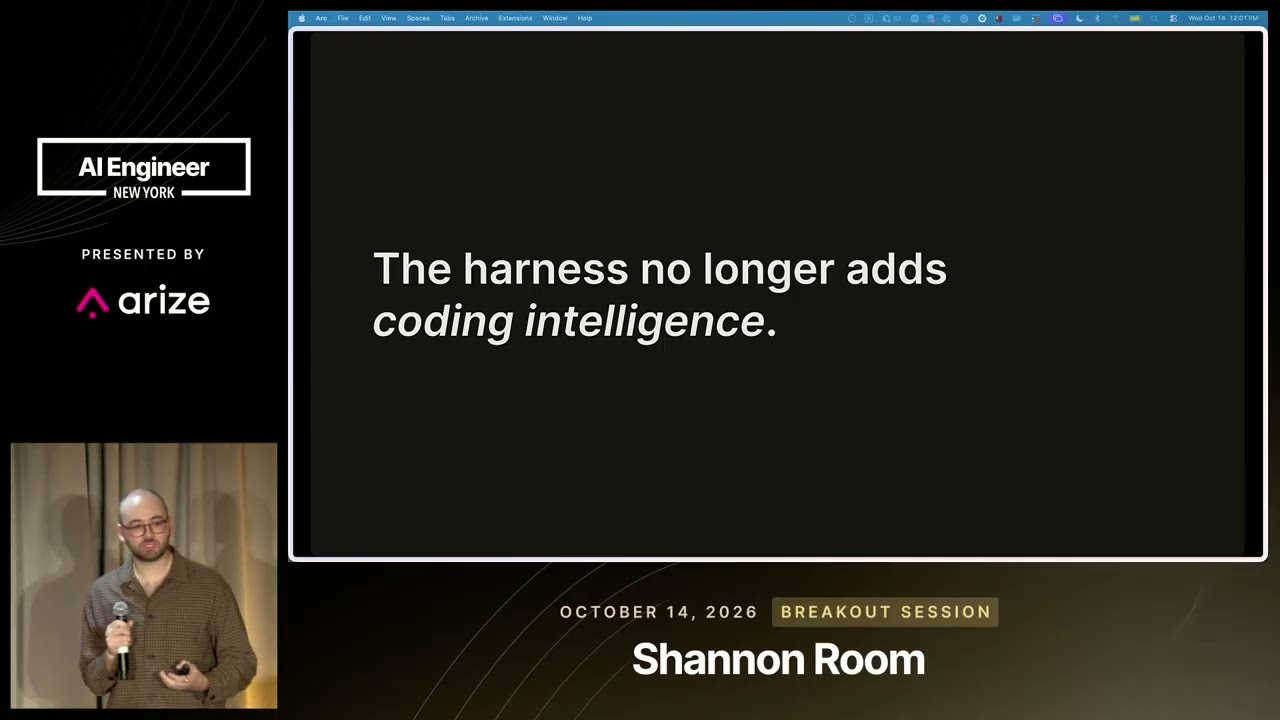
这不是修辞,是列了清单的减法。Cursor 删掉的东西包括:
- 负责「把模型给的 diff 应用到代码里」的小模型——以前需要一个专门的小模型干这件脏活,现在前沿模型自己就能稳稳地输出可应用的补丁。
- 教模型「怎么探索代码库」的指令——那些「先读这个文件、再搜这个符号」的提示词,正在变成模型的默认能力。
- 教模型「怎么自查」的脚手架——跑测试、看报错、回头改,这些原本要写在系统提示里的流程,模型自己会走了。
但这里有个容易被跳过的推论:减法成立的前提,是模型自己会了。所以删掉的东西是能力的证据,不是这层东西的死亡证明。一个中间层能持续删自己,恰恰说明它还在做判断——判断哪些活已经不该由人来教了。
我们删掉的,是那些「教模型做它已经会做的事」的部分。
—— 演讲中关于 Cursor 阶段减法的核心逻辑(转述)
05 唱空的一方
说 harness 要死的人,论据其实相当硬Peak harness, and the backlash
演讲专门用一节处理反方观点,而且没有敷衍。两个被引用的说法都来自一线:
- Anthropic 的 Tariq 提到,Claude Code 删掉了绝大部分系统提示词——如果最强的那家都在删,那「写提示词」这门手艺看起来确实在缩水。
- YC 的 Garry Tan 更进一步:以后重要的只有 Skills。
这些声音的共同结构是:把「曾经必须写的东西」等同于「harness 本身」。而按第一性原理拆,harness 的定义是「模型之外的全部」,所以它的边界天然会随模型滑动。争论「harness 会不会死」,其实是在争论一个定义,而不是一个事实。
真正值得问的问题因此变了:在模型吃不到的地方,还剩哪些工作?这正是后半场的主题。
06 实证
研究说了什么:分数在趋同,成本在拉开What the research says
演讲里最有说服力的一段不是观点,是数据。两组独立研究指向同一个结论:
| 研究 | 设计 | 结论 |
|---|---|---|
|
UC Berkeley 「HarnessTax」 |
7 个前沿模型 × 3 个 harness(Claude Code / Codex CLI / Pi)= 21 种组合,跑 SWE-bench Lite 与 Terminal-Bench 2.0 | harness 对成功率的影响:SWE-bench Lite 上 ≤ ±2 个百分点,Terminal-Bench 2.0 上 约 ±5 个百分点;但单任务成本差异巨大 |
| Apple + EPFL | 专门的 MLE harness 在 MLE-Bench 上评测 | 同样没有带来显著提升 |
这两份数据是「harness 已死」论最硬的弹药,而讲者没有反驳它们——他换了指标。
怎么读这份数据,决定了你是唱空还是继续投入
如果「harness 的价值 = 提升准确率」,那么 ±2 个百分点意味着这层东西确实该退场。但如果把视角换成工程视角,同一份数据说明的是另一件事:「分数」这个维度正在被模型吃掉,而成本、可靠性、可控性这几个维度没有。
这就是为什么他把 efficiency(效率)单独列进「模型吃不掉」的清单。两个系统 eval 分数相近,一个任务烧 2 毛、一个烧 2 块,选哪个不是模型决定的,是 harness 决定的——缓存命中率、token 使用效率、哪一步走便宜模型,全是外壳的选择。
07 飞轮
数据飞轮:它让 harness 变强,也让它更快过时The data flywheel
飞轮的逻辑很朴素:用得越多 → 真实任务轨迹越多 → 越清楚模型需要看到什么 → 表现越好 → 用得更多。
但讲者点出了它的另一半:飞轮转得越快,说明模型吸收得越快。你今天写的最聪明的提示词,明年大概率是模型的内置能力。所以 harness 团队的日常不是「积累」,而是持续的自我否定——每半年回头审一遍,哪些东西现在该删了。
一个极端的案例:Grind Swarm
为了试长时运行 harness 的上限,Cursor 用一个叫 Grind Swarm 的 harness 从零写出了一个浏览器。这件事的看点不是「AI 能写浏览器」,而是它的代价:成本极高,而且据说把 Cursor 搞宕机过一两次。
这个案例的教训很工程化:长时任务里,harness 的瓶颈不是「够不够聪明」,而是扛不扛得住——状态会不会丢、能不能断点续跑、并发和资源会不会把自己打穿。这类问题不会随着模型变强而消失,反而会因为任务变长而放大。
08 加回来
在 Grok Bot 里,他们反而把提示词和护栏加了回来The harness unlocks the next frontier
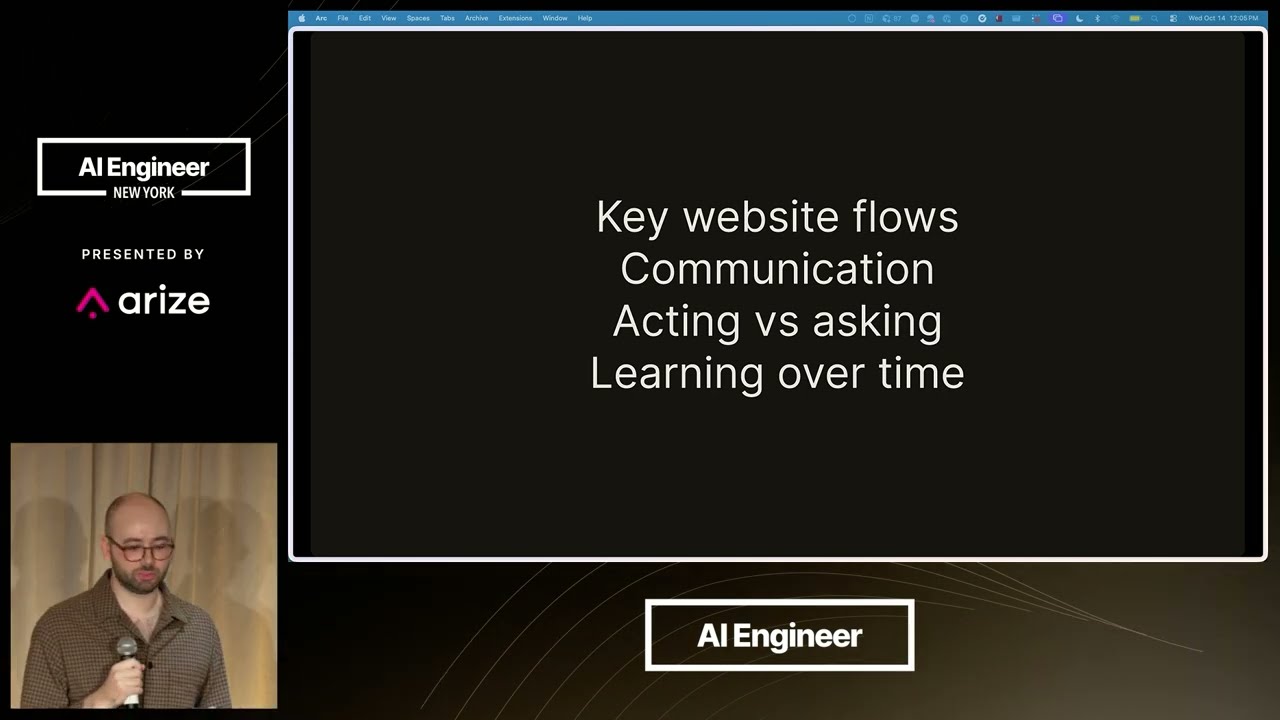
这是整场演讲最有意思的反转。在 Cursor 里做减法的人,到了 Grok Bot 却在做加法:新的提示词、新的防护措施,一样样加回来。原因是任务类型变了。
- 关键网站流程——帮你订行程、填表、下单。这些流程没有 API,只有界面,且每一步都可能失败。
- 沟通——做完事要汇报,但汇报不能打扰人。什么时候发、发到哪、说多少,全是判断题。
- 动手还是先问(Acting vs asking)——最核心的一对矛盾。不问就做,容易铸成大错;什么都问,等于没帮上忙。
- 随时间学习——记住用户的习惯、偏好、上次的坑,而不是每次从零开始。
在 Grok Bot 里,我们发现自己反而把很多东西加了回来:新的提示词,新的防护措施。
—— 演讲原话(据会后整理稿转述)
为什么这些任务需要把「旧东西」加回来?因为新任务不是靠更强的推理进入的,是靠更大的授权进入的:允许它碰你的账号、你的日程、你的钱,允许它反复来问你。授权一旦扩大, 护栏就必须存在——这不是技术退步,是边界扩张的必然成本。
09 核心清单
模型吃不掉的四件事What models can't absorb: new frontier / infra / trust / efficiency
如果整场演讲只能记一页,就是这一页。讲者把「不会被模型吸收的部分」归纳为四类,前三类是官方的章节名,第四类是他反复强调的隐性维度:
01 / NEW FRONTIER
把没被做过的事,变成可做的事
模型能让已有任务做得更好,但「哪种任务值得交给 agent」是外部判断:做幻灯片、订行程、管日程、替人汇报。这类扩张靠的是产品判断与授权设计,不是参数。
02 / INFRA
任务从几分钟变成几天,就必须上云
短任务可以跑在笔记本上,几天的任务不行:要持久化的状态、要断点续跑、要并发、要计费、要可观测。这些是基础设施问题,模型再强也不会替你做。
03 / TRUST
权限、灾难性操作、以及一万美金的账单
按 agent 收窄权限、按人收窄权限;防止一个循环把生产库删了;也防止一个循环把 API 账单刷到五位数。信任不是模型能力,是制度设计。
04 / EFFICIENCY
同一个分数,差一个量级的成本
eval 分数接近的系统,单任务成本可能差十倍。缓存命中率、token 效率、模型组合策略——这些优化没有上限,也没有终点。
一句话总结这四件事:模型的进步把「能力」变成了商品,把「边界、基础设施、信任、经济性」留成了工程。而后者恰好都是无法被一次模型发布覆盖的东西。
10 预测
六个月,九成的 Agent 工作会离开笔记本What's next for harnesses
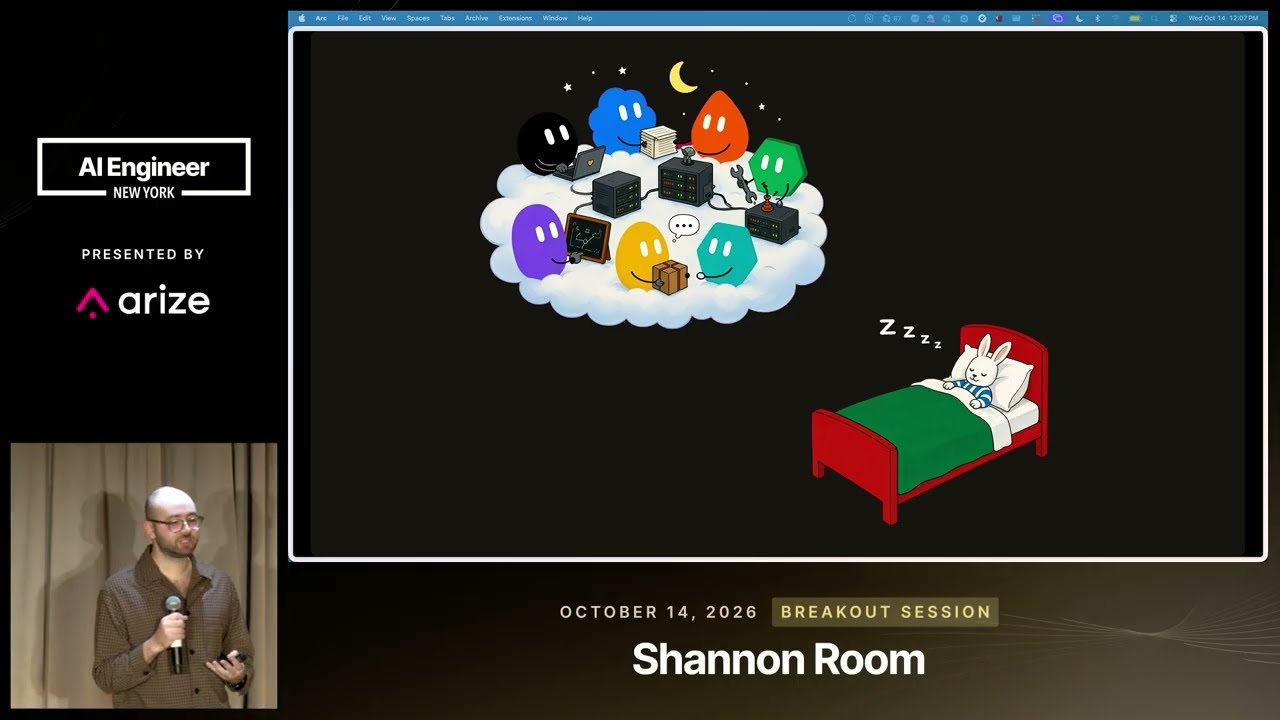
讲者的预测很直接:六个月内,90% 的 agent 工作会离开笔记本电脑,在云端运行。
这条预测和「harness 不死」其实是同一件事的两面。任务一旦长到以「天」为单位,笔记本就是错误的执行环境:它会休眠、会断网、会被人合上。而把 agent 从本地搬到云上,本身就是一个纯粹的 harness 工程——状态怎么持久化、连接怎么恢复、权限怎么下发、成本怎么计量。
剩下那 10% 也很清楚:人在现场、需要低延迟、或数据不能出门的场景,会继续留在本地。
11 Long live the harness
所以,Harness 会死吗Long live the harness
答案是:「替模型补短板」的那部分 harness 会死,而且死得很快;「替人立规矩、扛责任」的那部分不会。
这场演讲最值得带走的方法并不是某个结论,而是一种审阅习惯:把所有 harness 组件摊开,逐个问一句——这是在补模型不会的东西,还是在定义一件模型不该自己决定的事?前一类每半年清一次,后一类每半年加固一次。
12 出处
来源与制作说明Sources & notes
一手来源
-
演讲视频(AI Engineer 频道,约 19 分钟,官方章节 0:00 / 1:09 / 2:02 / 2:59 / 5:00 / 6:16 / 7:34 /
12:07 / 14:21 / 17:36)
https://www.youtube.com/watch?v=7Y4sbZgBdnc - 大会官方推文:Inside Grok Bot: is the agent harness dead? https://x.com/aiDotEngineer/status/2112665680348660147
- 视频内 4 张画面帧(封面架构图 + 3 张自动截帧,分辨率 1280×720),直接取自该视频的缩略图 CDN。
二手参考
-
会后中文整理稿:Jediah Katz 谈 Agent Harness 未死:编码补丁被模型吸收,开拓任务、安全与效率仍离不开它(2026-10-21)
https://aihot.virxact.com/items/d8bsm5mstrm10n5d81pyuqecu -
播客转录整理:#792. SpaceXAI 工程师:Agent Harness 已死?(2026-10-19)
https://bbs.hupu.com/643286735.html -
Harness 定义与拆解:深度拆解:AI 智能体 Harness 的构造(2026-05-18)
https://www.cnblogs.com/sexintercourse/p/20072489 -
HarnessTax 讨论:Claude Code 近一半流量在跑别家模型:伯克利给「换壳省钱」起了个名字,Harness 税(2026-09-25)
https://post.smzdm.com/p/al3lzqpe/ -
相关论文:Measuring the Microtask Eligibility Gap: When Is an Off-the-Shelf SLM Enough for an Agent
Harness?(arXiv:2610.00025,2026-09)
https://arxiv.org/abs/2610.00025